从 Demo 到可靠 Agent:工具调用、规划与评估的工程实践
从能跑通到可上线:用工具契约、规划回路、状态与评估,把 Agent 不确定性收进可测试结构。
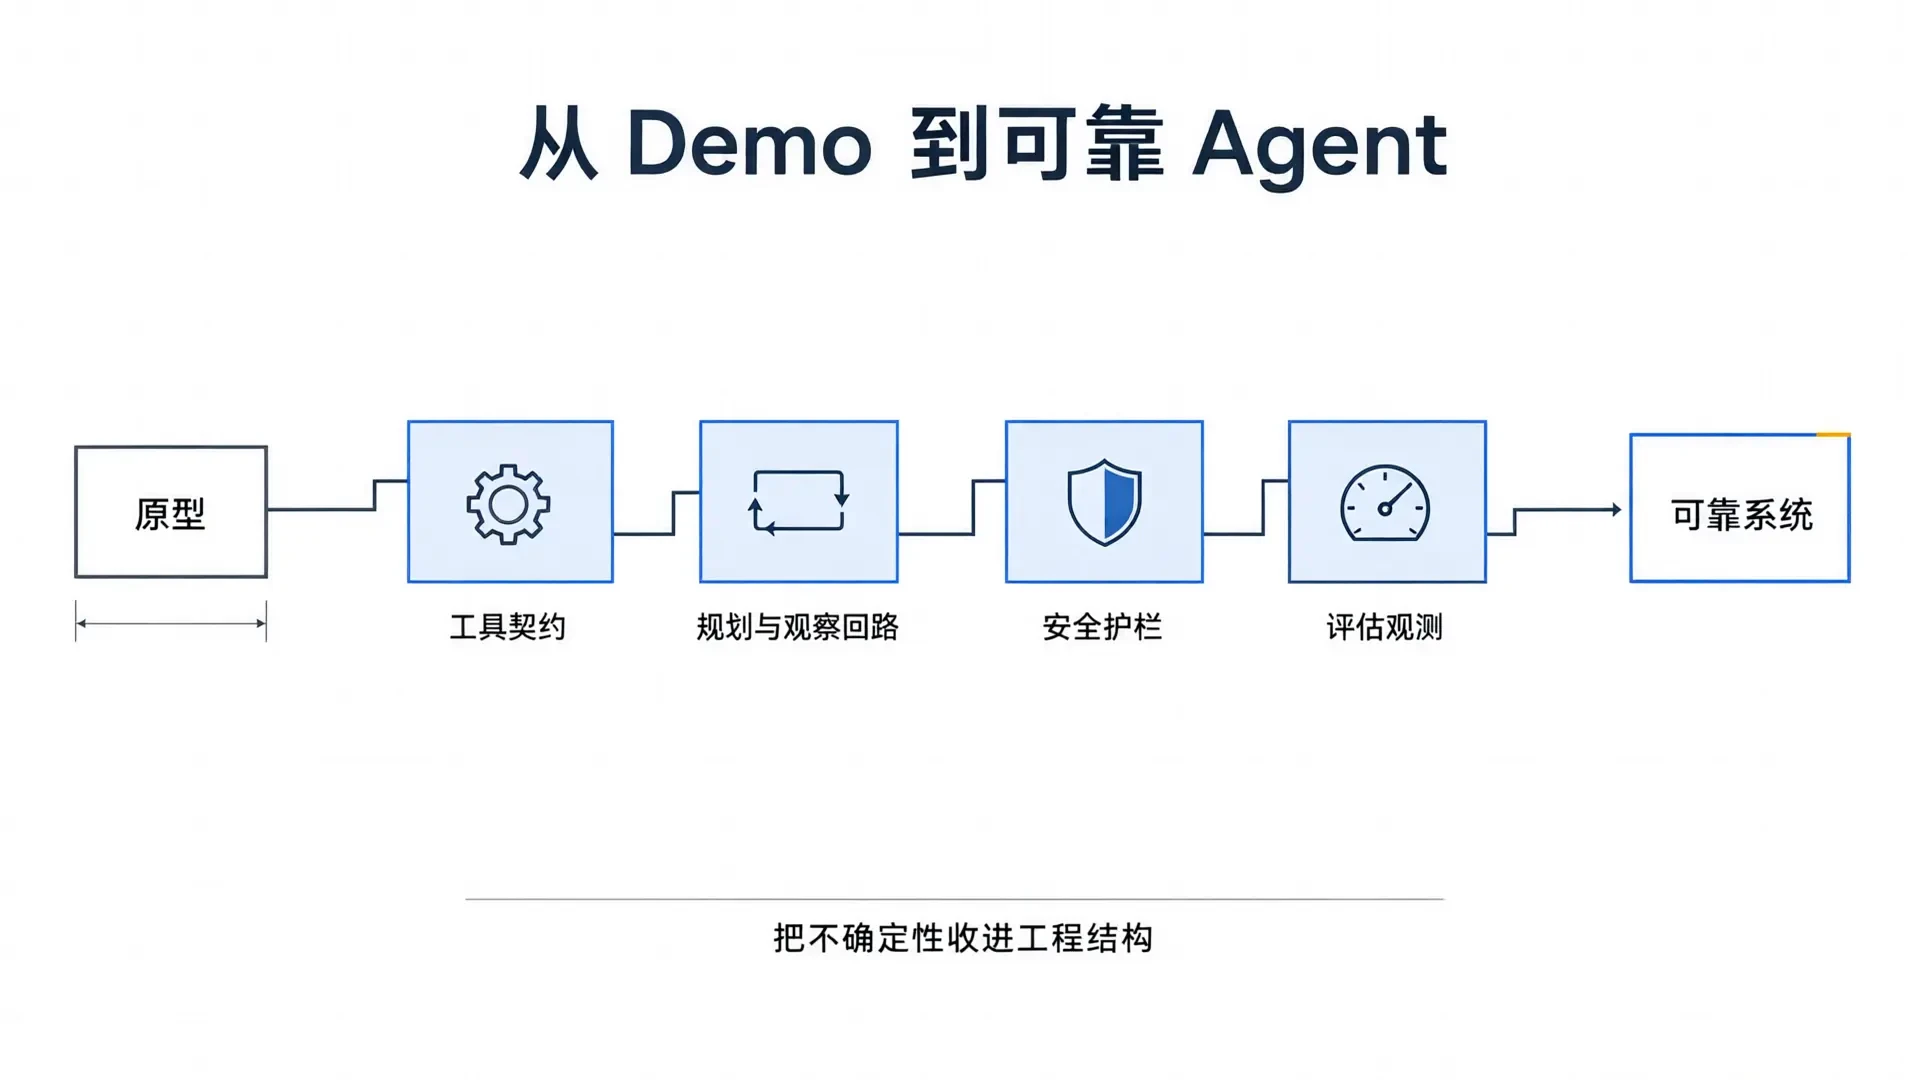
一个能在终端里跑通订票流程的 Agent,要变成能在生产环境连续运行、出错能兜住的 Agent,中间补上的往往是一整套工程约束,模型版本反而排在后面。演示环境里输入是挑好的,工具永远返回成功,超时和并发都不存在;生产环境里工具会返回 500、返回一段网页 HTML、返回过期的缓存,用户会在第 7 步改变主意。把 Agent 推上线,本质是把这些不确定性逐条收进可测试、可观测、可回滚的结构里。
一、先把问题界定清楚:能跑通不等于可靠
工程上值得把三类系统分开对待。单轮问答只做一次生成,没有外部副作用,出错最多是答得不好。工具增强问答在生成前后挂一次检索或查询,动作是只读的,失败可以重试。会多步行动的 Agent 则要在一次任务里连续调用工具、根据返回决定下一步,它同时具备决策和副作用两重属性,这才是需要工程化治理的对象。
把这套系统跑坏的原因,很少是模型不够聪明。更常见的是四类结构性缺陷:相似工具之间边界模糊导致选错;上一步的返回值没有进入下一轮决策,观察被忽略;多轮之后 Agent 忘记初始目标,状态发生漂移;循环没有出口,缺少停止条件。这四类问题都能在不换更强模型的前提下修掉,靠的是接口、状态和评估的约束。
二、工具契约:把 tool calling 当成接口设计
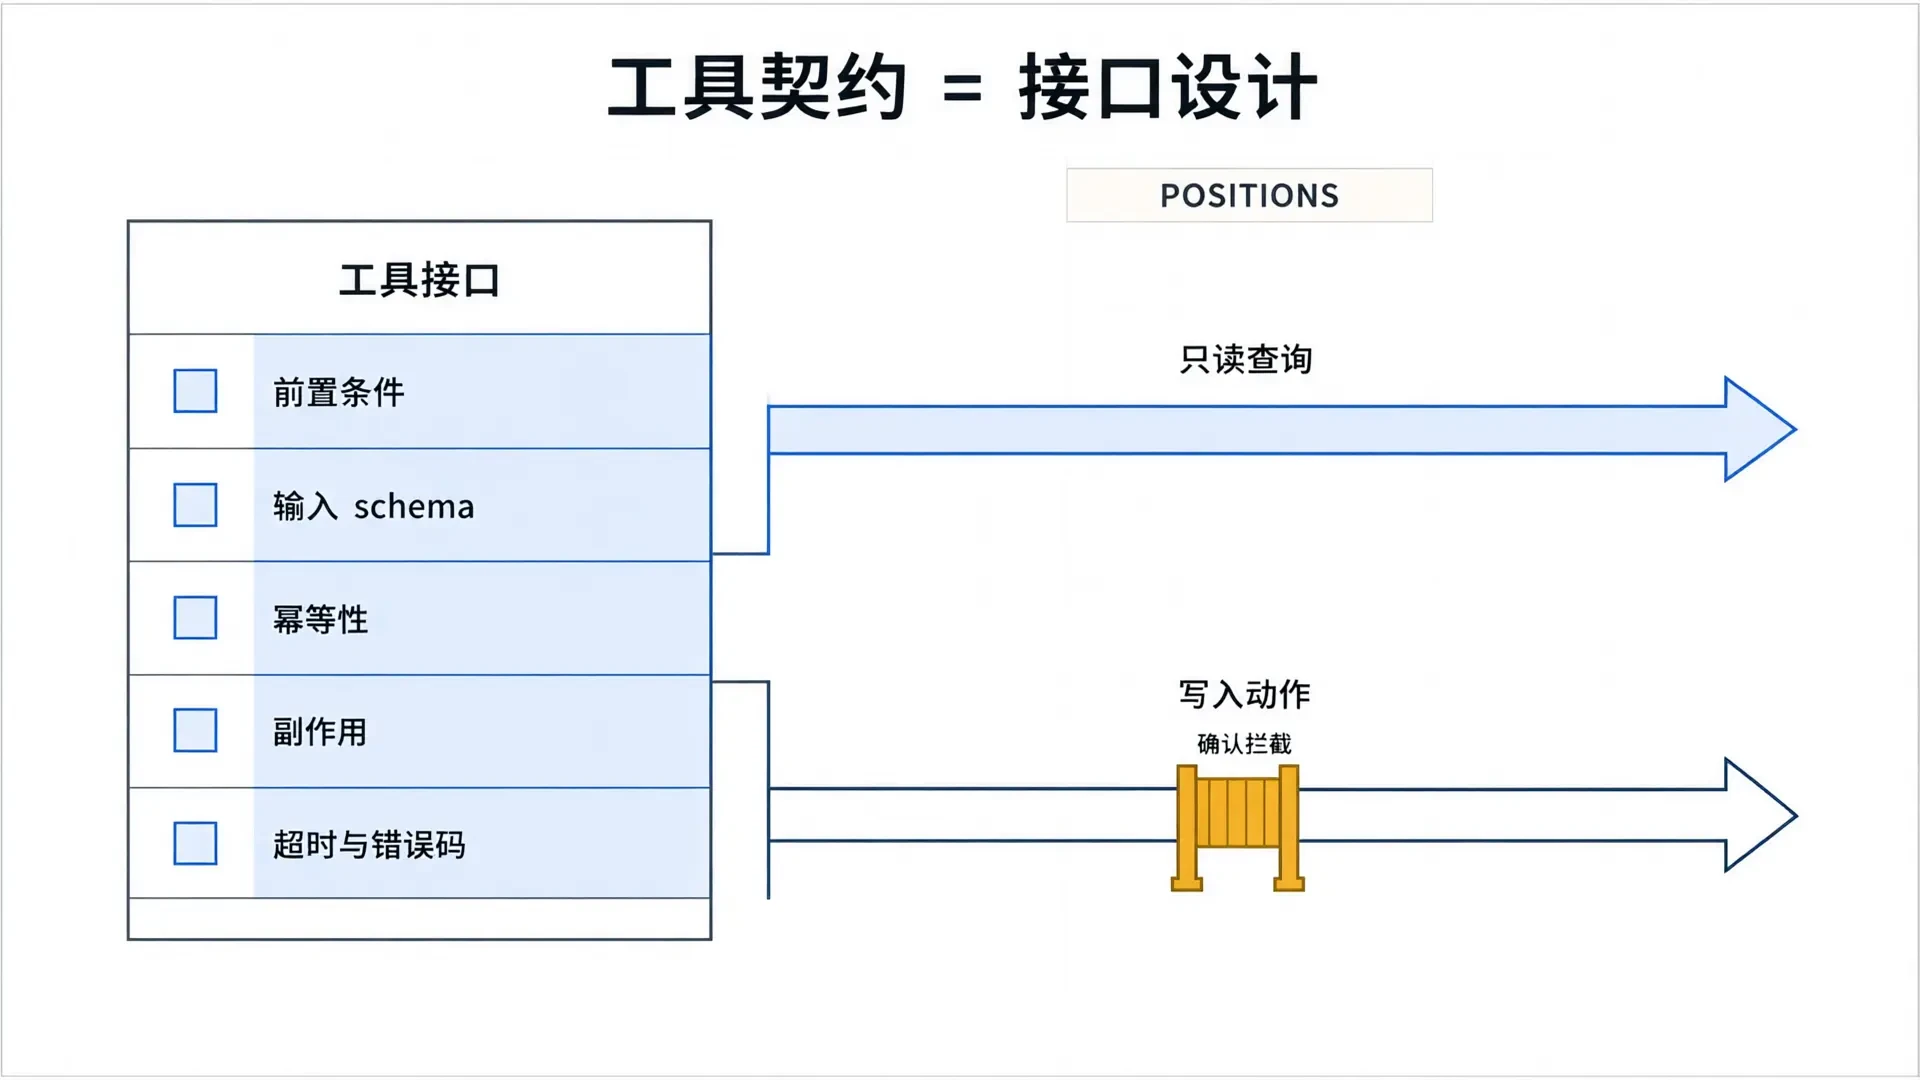
把工具调用当成接口设计,不要随手注册一个函数就算接入。每个工具至少要写清五件事:前置条件,调用它需要哪些状态已经就绪;输入 schema,字段类型、必填项和取值域;幂等性,重复调用是否安全;副作用,是否会改变外部世界;超时与错误码,多久算超时、失败返回什么、哪些错误可以重试。
权限按最小化处理,只读查询和写入动作分成两组工具,写操作单独走一条更严格的路径。检索、查库、读文档只暴露只读工具;真正改数据的动作必须带明确的确认参数。工具的描述同样当接口文档写,模型是依据描述做选择的,两个功能相近的工具如果描述含糊,选错几乎是必然。宁可把工具切细、边界写清,也不要留一个包打天下的万能工具。
{
  "name": "get_order_status",
  "description": "查询单个订单的当前状态,只读,可安全重试",
  "input_schema": {
    "order_id": "string, 必填, 订单号",
    "trace_id": "string, 必填, 用于链路追踪"
  },
  "side_effects": "none",
  "timeout_ms": 3000,
  "retryable_errors": ["timeout", "rate_limited"]
}
三、规划与观察回路:先想后做,还是边走边看
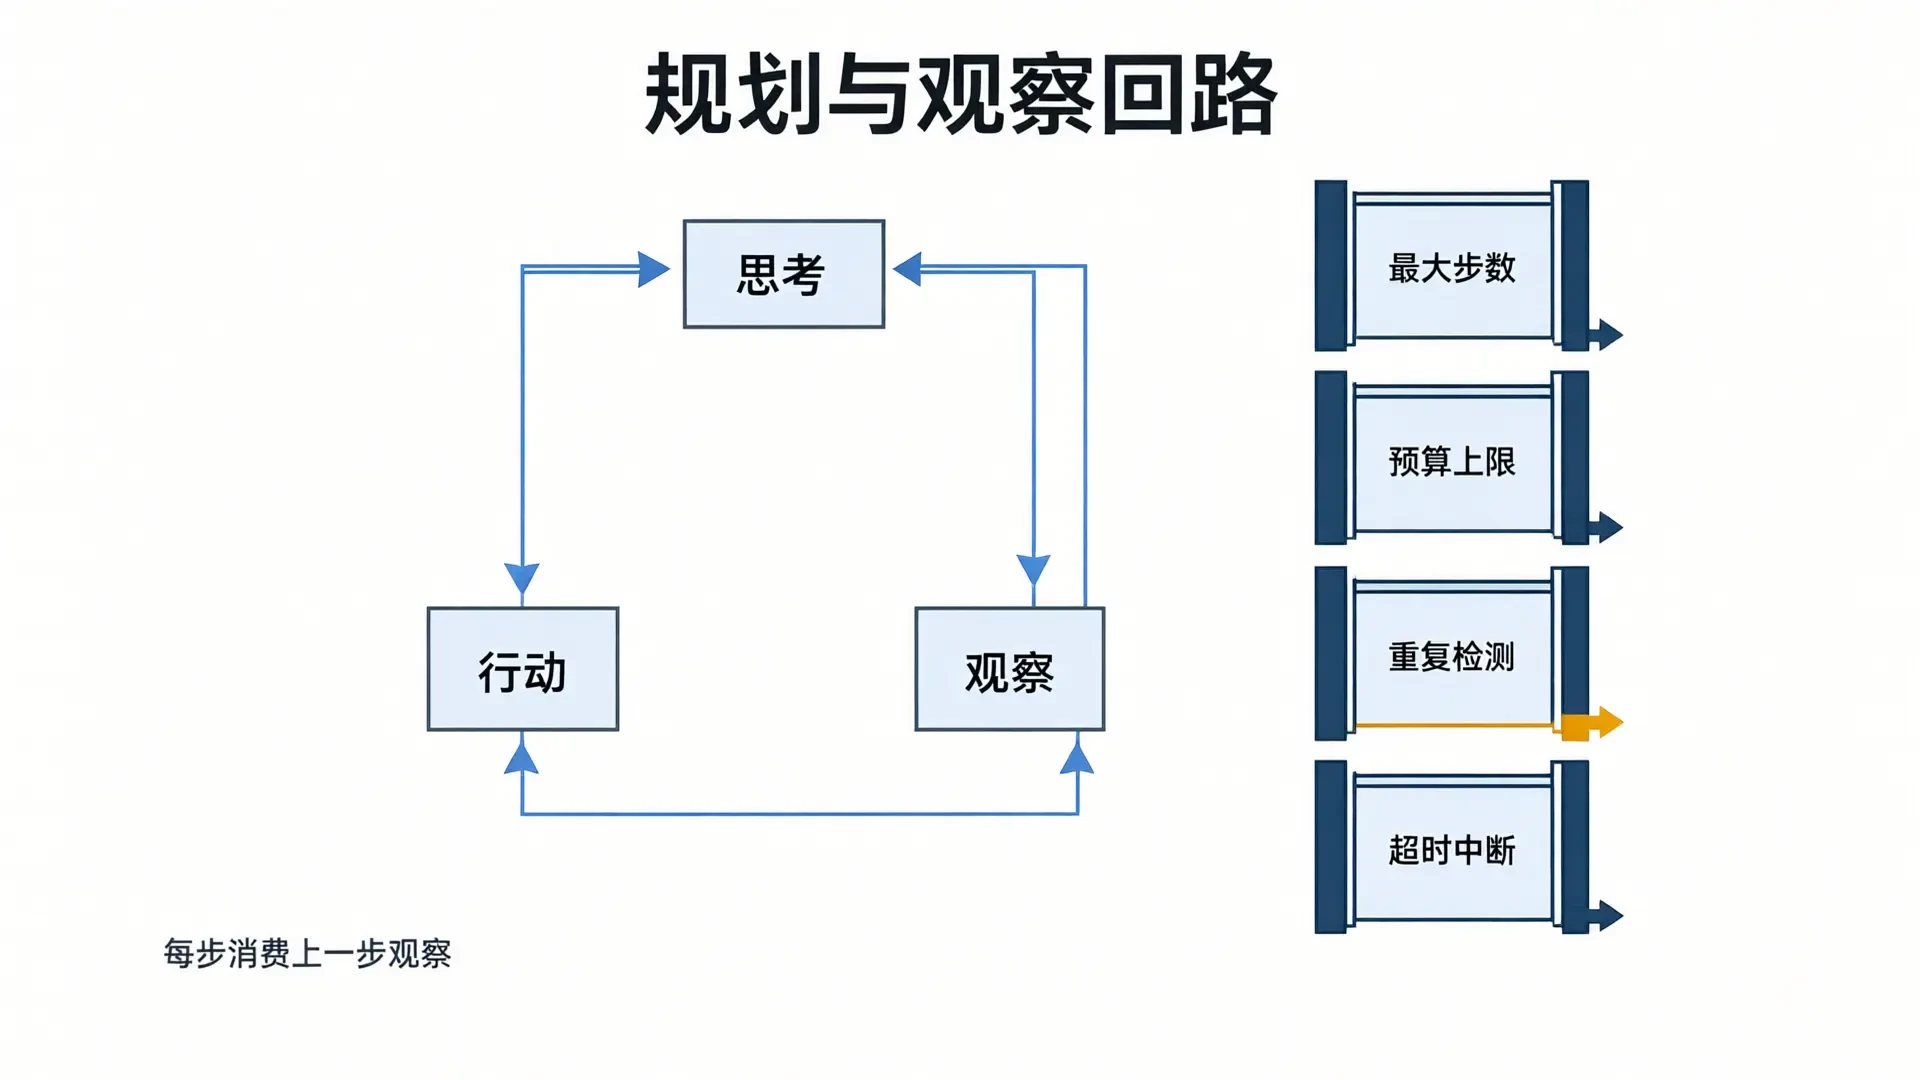
ReAct 式的循环把一轮决策拆成思考、行动、观察三段:模型基于当前信息判断该做什么,选一个工具并给出参数;工具执行后,结果作为 observation 回填;下一轮决策必须消费这条 observation。回路有一条关键纪律,每一步都要显式引用上一步的结果,而不是把历史整段丢回去让模型自己去找。
什么时候用显式计划(plan),什么时候让模型逐步决策,取决于任务的确定性。步骤稳定、依赖清楚的任务适合先拆步,把每步目标和验收口径写出来再执行;环境反馈不确定、需要临场调整的任务适合逐步决策,让模型看着 observation 走。更常见的是两者混合:先产出一个高层计划约束方向,执行阶段仍逐轮决策,允许计划被观察结果修正。计划用来锁定方向,不当作逐字执行的剧本。
防止死循环要有几道硬出口。设一个最大步数,超过就直接返回已完成的部分并标注未完成,不再继续试;设一个预算上限,按 token 消耗或工具调用次数计,和成本直接挂钩;再加一个重复检测,对连续相同的工具加参数组合计数,达到阈值就中断并要求换策略;最后留一条超时中断,防止单个工具把整轮任务拖住。这几道出口都写在模型之外,由调度层强制执行,不能指望模型自觉。
四、状态与上下文:什么该记在脑子里,什么该落库
短期工作记忆是当前任务的轨迹,记录做过什么、得到什么、还差什么。长期记忆是跨任务保留的事实,包括使用者偏好、历史结论、结构化的业务数据。两者的边界要分清,不能混在同一个提示词里放任增长。
需要精确、需要被引用、会随时间变化的事实,都应该结构化落库,而不是以自然语言形式塞进上下文。订单号、金额、时间戳、状态枚举这类字段一旦在上下文里漂移,出错后几乎无法追查。可靠的记忆方式是索引到结构,用标识符去取最新值,而不是复述一堆可能过期的文本。
上下文裁剪时最容易丢的是工具结果的来源与时间。裁剪可以丢掉中间推理和冗余历史,但每条保留下来的工具结果都要带上来自哪个工具、什么时候取的。否则模型会拿过期数据当成最新状态去做决策,这类错误在日志里往往表现为莫名其妙的参数。
五、安全边界与 guardrails:把校验放在模型之外
guardrails 的作用是把一部分判断从模型手里移出来,交给确定性的代码。高风险动作,比如支付、删除、对外发送,不能只靠模型想清楚,要在执行前加一道确认或策略拦截:参数校验、金额上限、目标白名单、二次确认,任一条不过就拦下。
提示注入是绕不开的。工具返回值里可能夹带指令性文本,网页内容、上传的文档、第三方接口的说明字段都算,这些内容一旦进入回路,可能被模型当成指令执行。处理办法不是让模型学会分辨,而是隔离:把工具返回值标记为数据而非指令,对其中要求执行的动作做白名单校验,写操作一律走独立确认。
校验要放在模型之外。输出格式、参数取值、状态转换是否合法,都交给代码判断,模型只负责生成候选,代码负责放行或拒绝。模型本身是不确定的,护栏必须是确定的,这两层不能混。
六、评估与可观测性:看轨迹,不只看答案
离线用例集至少覆盖四类场景:能正确完成的成功案例;只完成部分步骤并如实报告的部分成功;该被拒绝的危险或不合理请求;诱导模型选错工具的工具误用。用例不在于多,而在于把已知的失败模式各留一条,让每次改动都能回归验证。
指标分两层。过程指标看 Agent 是怎么走的,包括平均步数、工具命中率、无效重试次数、人工介入率;结果指标看任务是否真正完成,包括成功率、部分完成率、错误拒绝率。只盯最终答案会漏掉大量隐患,一个靠反复重试碰对的 Agent,成功率看着不错,成本却在失控。
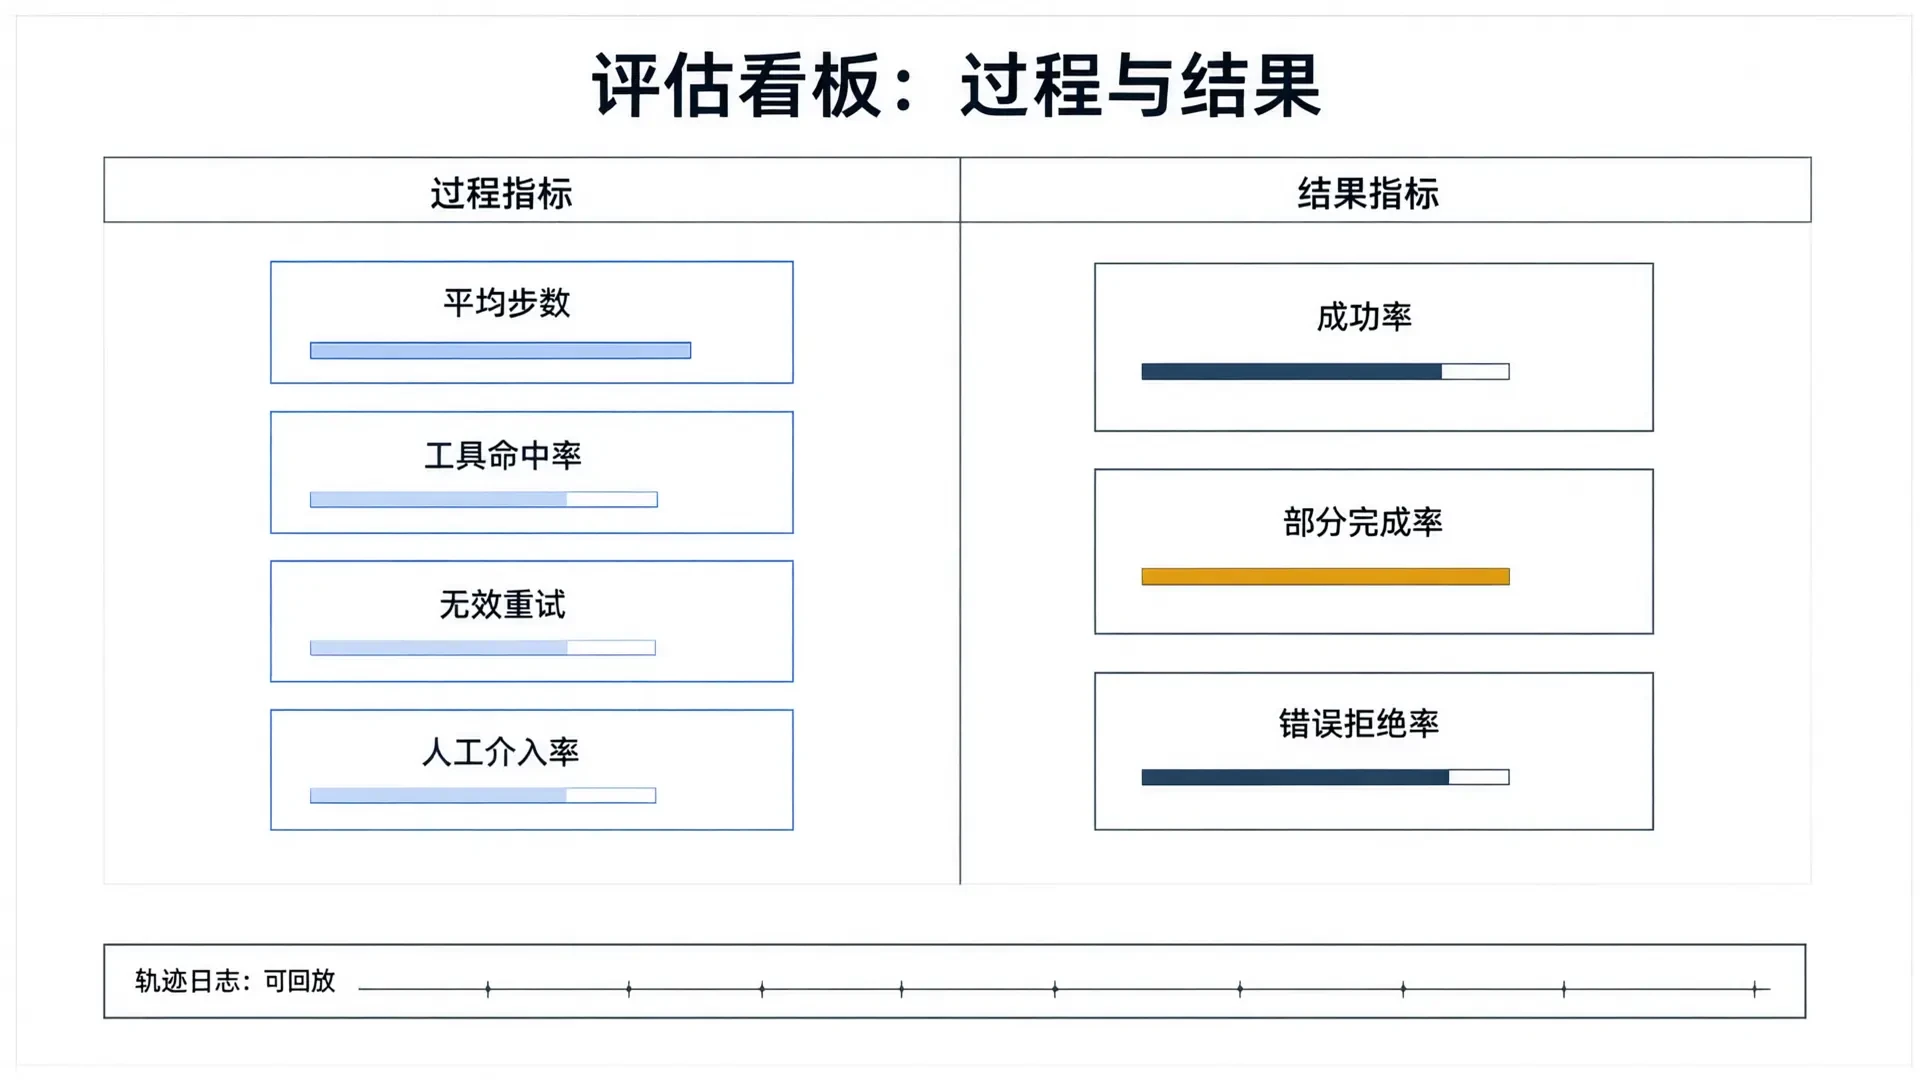
轨迹日志是复盘的唯一依据。每一步的思考、工具、参数、返回值、耗时都要留痕,这样才能回答它在第几步开始跑偏。没有轨迹,评估只能停在这次答得还行这种模糊判断上,改动也就无从归因。
七、落地清单:从 Demo 到小流量上线
从 Demo 走向小流量上线,不需要一次做全,但有几项缺一不可:只放行经过验证的工具白名单;给每个任务设步数与成本上限,触发时告警;把核心任务的端到端用例接进持续集成;准备好失败降级路径,超限或异常时转人工,或者退化成只读模式。
上线前对照下面这份清单逐条确认:
- 每个工具都有 schema、超时和错误码,写操作与只读操作分离
- 回路具备最大步数、预算上限、重复检测和超时中断四道出口
- 需要精确的事实来自结构化存储,上下文只保留指针与来源时间
- 高风险动作有模型之外的确认或策略拦截
- 输出格式与工具参数由代码校验,不依赖模型自觉
- 离线用例覆盖成功、部分成功、应拒绝、工具误用四类
- 过程指标与结果指标同时上报,轨迹日志可回放
- 关键路径进持续集成,超限时有明确的降级路径
文 / Shadow_Noke
CC BY-NC-SA 4.0 · 转载请注明作者与出处